人工智能大解密
1.人工智能概念(AI:Artificial Intelligence )
-概念-
人工智能即让机器像人一样智能处理事务,具备感知、学习、推理、决策、创造等认知能力、控制能力及行动能力。
-等式表示-
人工智能 = 感知(传感器) + 体能(算力) + 认知(算法/大模型) + 行动(执行器与控制逻辑) + 生命(能源)
-什么是AGI(通用人工智能)?-
指达到甚至超越人类水平、能完成任何智力任务的AI,目前尚未出现。
当前我们使用的所有 ChatGPT、文心一言、行业大模型都属于窄人工智能(ANI),只能完成单一 / 限定领域任务;AGI 通用人工智能是具备跨领域自主学习、通用逻辑、自主目标规划的智能,学界普遍认为短期内无法实现。
-分类及现状-
AI 三大分类
窄人工智能 ANI:现有全部商用 AI,单一领域专用(聊天、画图、自动驾驶)
通用人工智能 AGI:通用跨领域自主智能(未实现)
超人工智能 ASI:智力全面碾压人类,仅理论设想
1.1 算力
-算力是什么?-
算力 = GPU芯片的“数量” × 芯片的“利用率” × 互联的“效率”。
-算力的角色?-
没有算力,大模型也能跑——但可能跑一次需要几百年。
极小参数量模型(百万参数)普通 CPU 即可运行,只有千亿、万亿大模型训练 / 推理才依赖高性能 GPU 集群。
缩放定律(Scaling Law) :模型性能跟参数规模和训练数据量,基本遵循幂律增长。 简单说,参数翻10倍,智能可能翻3倍,但需要的算力翻100倍。
-GPU了解-
GPU(图形处理器):GPU 擅长并行矩阵运算,但串行逻辑运算弱;是最核心的算力来源。它内部有数千个"小计算核心",可以同时做大量简单乘加运算——正好契合大模型的矩阵乘法需求。
除 GPU 外,行业专用算力芯片:**谷歌 TPU、移动端 NPU、国产 AI 专用 ASIC 芯片,**针对大模型做了架构优化,训练 / 推理能效比高于通用 GPU。
1.2 大模型(AI程序)
1.-大模型的组成与分类-
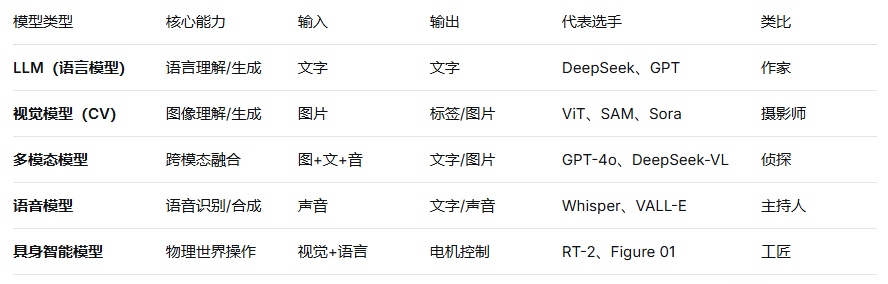
主流大模型基于 Transformer 深度学习架构,以海量文本 / 图像 / 音频多模态数据为训练素材,通过神经网络拟合数据分布,核心能力为序列预测(文本模型预测下一个文字,多模态模型预测图像、音频片段)。
2、大模型会思考吗?
不会“思考”,而是通过数学算法“计算概率”,比如“窗前明月”后面是“光”的概率更高,当前它存储了词与词之间的数学关系。
3、什么是预训练和微调
**预训练:**基础底座训练,用全网海量无标注原始数据,让模型学习通用语言、常识、基础逻辑;成本最高,消耗绝大多数算力;
**有监督微调 SFT:**人工标注高质量指令问答数据,教模型听懂人类指令、规范输出格式;
RLHF 人类反馈强化学习:在微调基础上,生成多条答案,人工打分排序,训练奖励模型,反向优化大模型输出对齐人类价值观、拒绝有害提问。
4、大模型的推理
推理阶段依靠预训练学到的海量文本关联概率,结合输入上下文,逐一生成文字;所谓逻辑只是数据中统计出来的语言关联,并非自主推导。
5、大模型的缺点
幻觉:因为大模型只算概率,不讲事实,当拿不准“高概率”词是什么时,它会编造一个看着像真话的假话。
数学短板:计算时是背出来的,算复杂乘法,它容易算错,必须调用外部计算器(插件)。
上下文窗口限制:超长文本会丢失前置信息,出现遗忘;
价值观偏见:复刻训练数据中人类自带的性别、地域、认知偏见;
举例:
计算8674 × 3251:
拆成了它“见过无数次的微模式”:
它见过 8×3=24(模式)
它见过 六千×三千≈一千八百万(量级模式)
它见过竖式乘法的“进位描述”(语言模式)
于是它拼凑出一个看起来合理的答案。
1.3 智能体是什么?
以大模型为核心大脑,具备感知输入、自主规划、工具调用、多步骤任务执行、结果复盘修正能力的软件系统,可自主拆解复杂长任务,而非仅单次问答。
本身是一个软件。例如:OpenClaw。
智能体 = 大模型(大脑) + “执行”,也就是:大模型大脑 + 记忆模块(短期上下文 / 长期知识库) + 规划模块 + 工具调用模块 + 反思模块。OpenClaw是基于大模型的智能体,能做简单规划,调用工具完成任务。
目前,高级智能体正在研发中,智能体是通往AGI的必经之路。
1.4 具身智能体是什么?
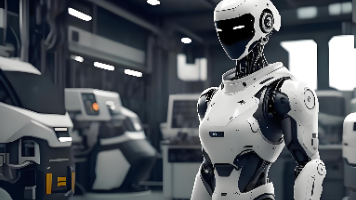
具身智能 = 大模型(大脑) + 机器人(身体) + 物理环境(工厂),能通过传感器感知物理世界、并通过执行器在物理世界中行动和学习的智能系统。
物理环境不限工厂,家庭、道路、实验室都属于;
纯数字具身智能:虚拟数字人、游戏智能体,无实体机器人
电影级数字人,免显卡端渲染SDK,十行代码即可调用,工业级demo免费开源下载!
更多推荐
 9
 0
- 0


 已为社区贡献1条内容

所有评论(0)